career-ops
Open-source AI job search agent and job finder: scan job boards, score each job 1-5 against your CV before you apply, tailor an ATS-friendly resume and cover letter, get interview prep and a job application tracker. It helps you fill in each application; you press Submit. Runs locally in your AI coding CLI (Claude Code, Codex, OpenCode and more).
原始仓库简介 · 中文摘要待补充 · agent-skills / ai-agent / ai-job-search / ats / career / career-ops
README / 项目原文
The open-source AI job search agent.
English | Español | Deutsch | Français | Português (Brasil) | 한국어 | 日本語 | 简体中文 | 繁體中文 | Українська | Русский | Polski | Dansk | தமிழ் | العربية | हिन्दी | Türkçe | Tiếng Việt | Bahasa Indonesia
 Created by @santifer, with
 700+ contributors
Months of sending CVs into silence.
So I built the filter I needed.
740 listings evaluated. 68 applied. 12 interviews. 1 offer.
I was its first user. I got the job. Then I open-sourced it.
Paste a job. On your machine, it tells you if it's still open and if it fits.
It tailors your CV and drafts your answers. You press Submit.
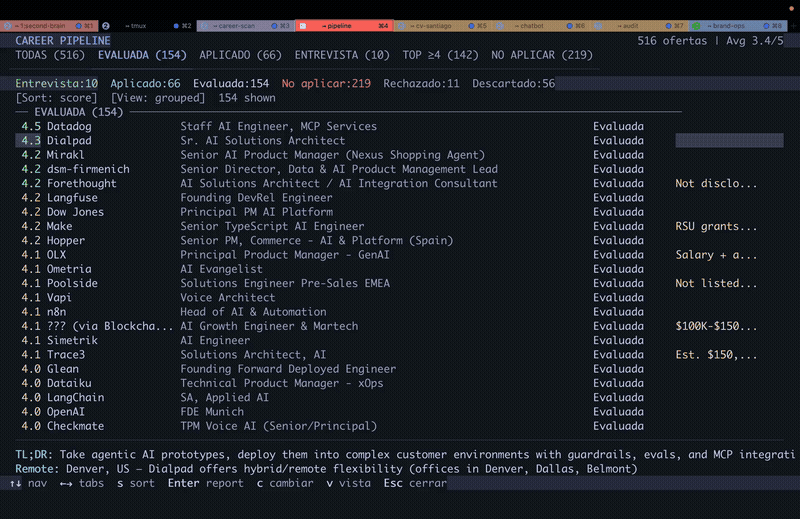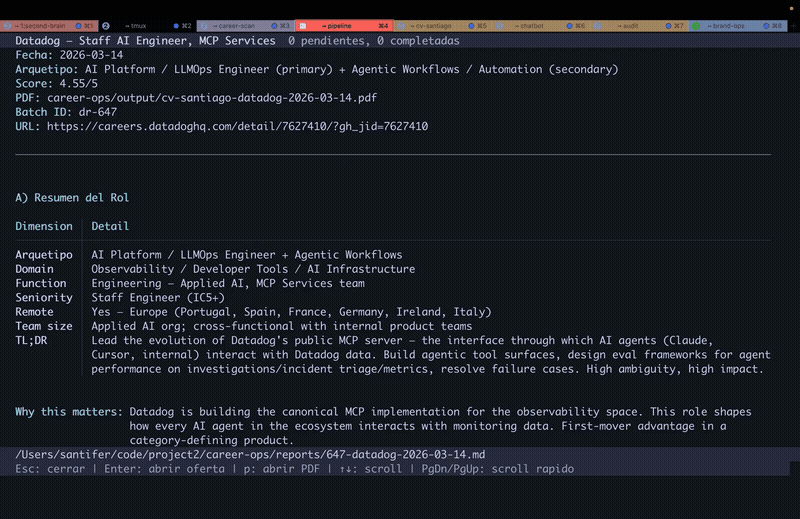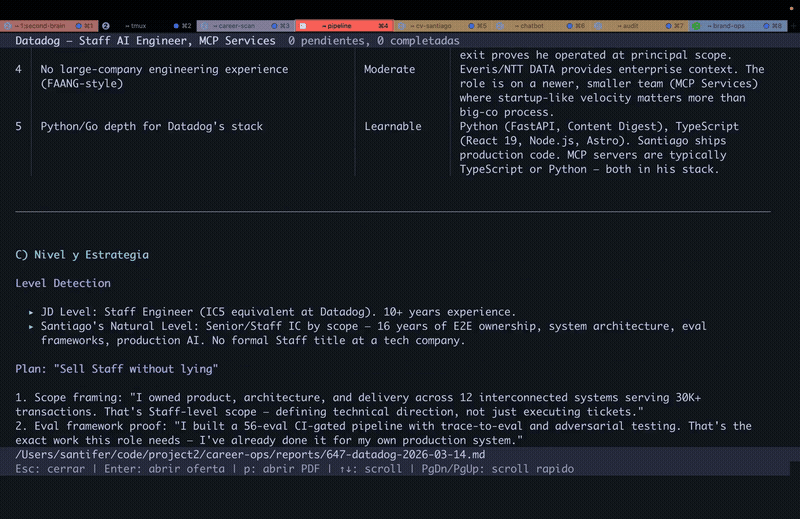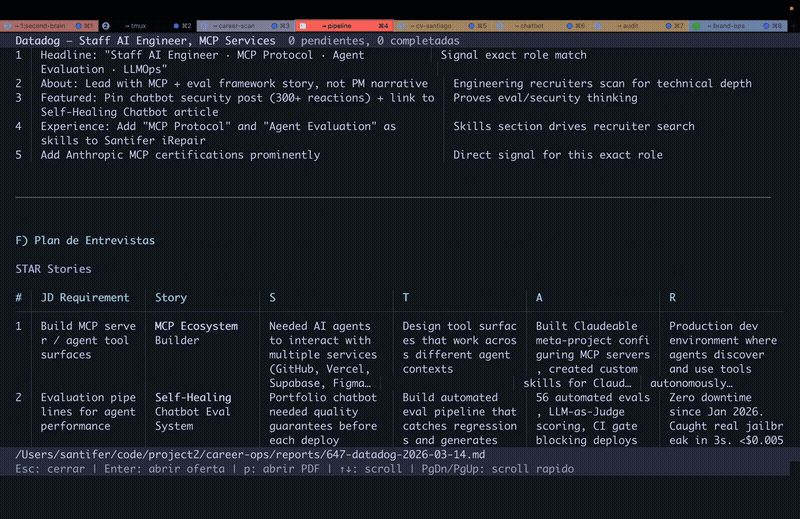
My own search, partway through, with the UI in Spanish.
Companies use AI to filter candidates.
I just gave candidates AI to choose companies.
Six months later, I left that job.
Now we build career-ops, so you can land yours.
Try it on one job ↓ · Read the full story →

The people who came after me wrote down how they got hired.
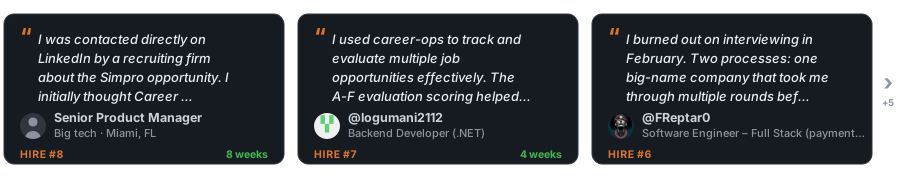
Every card is a public issue you can open. Landed yours? Leave your card →
⭐ If career-ops helped you, a star helps the next person find it.
Your turn
Paste one job you were about to apply to tonight. If it comes back do not apply, you just got the night back. If it comes back with a plan, you know what to do next.
npx @santifer/career-ops init
Open source. Local. In the AI CLI you already use. Free and local models included.
You don't have to search alone
The silence after you hit send is not about you. Enough people saw the same thing to write the practice down, in six lines:
Apply better to fewer. Signal over volume. Evidence over keywords. A human decides. Local-first. Dignity on both sides of the table.

A few of them, in their own words.
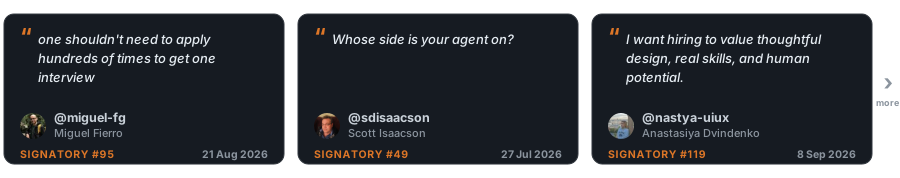
Every signature is a commit you can audit. Read them all, or add yours → · What is AI job search?
Hiring will not fix itself. The people going through it can, and they are already in the room, comparing notes and fixing each other's setups.
This is where the fix gets written. A room, not a club. Let's build together.

Sponsors
career-ops is free for candidates, forever. These companies sponsor the project:
SerpApi · Build a portfolio project with live search data. SerpApi gives developers structured JSON/Markdown from Google Search, Maps, Shopping, and other engines through a simple API call.
Sponsorship buys clearly labeled visibility, never influence: no amount of money changes the roadmap or places anything in the product. Sponsors never appear in evaluations, rankings or recommendations.
What career-ops does for you
Paste a job. It tells you whether that night is worth it.
- Still open? It checks that the posting is still live before you write a word.
- Not you? It scores the role against your real CV and tells you to skip a weak fit. You can override it.
- Worth it? It drafts the CV, the cover letter and the answers. You read them. You send them.
- Who do I talk to? It finds the person and drafts the note. It never sends it.
- Where does it all go? Every application stays on your machine. Nothing is uploaded to us.
- What should I learn? After a run of noes, it names the gap.
The first runs are rough. It does not know you yet. Talk to it: your CV, what you want, what you refuse. Think of it as a recruiter's first week.
On first launch it asks for all that in chat. Nothing to configure by hand.
What career-ops will not do
- Auto-submit an application. It drafts the answer to every field; you review and click Submit. The script never POSTs (
prepare-application.mjs). - Send an email. Drafts only. There is no mail transport anywhere in this codebase.
- Phone home. No telemetry, no backend of ours. Your CV goes from your machine to the AI provider you chose, and nowhere else. The only public ledger is this repo:
HIRED.mdand its issues. - Push you to apply below 4.0/5. It will tell you not to. You can override it, and it will say so.
It reformulates your CV; it must never fabricate it. A check in code stops a PDF whose numbers or facts appear in neither your CV nor your article digest, but it cannot judge every rewording yet. Read every CV before you send it. Details in the FAQ.
Features
| Feature | Description |
|---|---|
| A-H Evaluation | Role summary, CV match (with how much each requirement matters for this posting, and whether that weight came from the JD's own wording, its structure, or an estimate, labelled per requirement; an estimate can never be top-band), level strategy, comp research, personalization, interview prep (STAR+R) -- plus a Block G posting-legitimacy check (is it still open, is it a repost: observations, not verdicts), and a Work-Auth signal that flags an explicit no-sponsorship JD as a hard blocker |
| Human-in-the-Loop | AI evaluates and recommends, you decide and act. The system never submits an application -- you always have the final call |
| ATS PDF Generation | ATS-readable CVs tailored to each JD from your own experience, in Space Grotesk + DM Sans design |
| Cover Letter Generator | Research-backed cover letters with keyword mirroring, four interactive angle prompts (why/problems/approach/tone), draft-in-chat approval gate, and A4 PDF via the same HTML + Playwright pipeline as CVs. Auto-drafts on every evaluation; complete and generate on demand via /career-ops cover |
| Beyond the CV | Company research (deep) surfaces AI strategy, recent moves, engineering culture, and the angle your profile should take. Contact discovery (contacto) identifies the hiring manager, recruiter, or team peer worth reaching out to and drafts a ≤300-character LinkedIn message tuned to each contact type. Formal application email drafts (email) turn an evaluated report or pasted JD into a subject line, body, and attachment checklist without sending, submitting, or clicking anything. Applications get you in the queue; research gets you a conversation. |
| Pattern Analysis | Rejection patterns and per-ATS-channel advance rates (analyze-patterns.mjs), lifetime funnel stats (stats.mjs), repost detection, a possible sign of a ghost job (detect-reposts.mjs) |
Everything else it does
| Feature | Description |
|---|---|
| Auto-Pipeline | Paste a URL, get a full evaluation + PDF + tracker entry |
| Interview Story Bank | Accumulates STAR+Reflection stories across evaluations -- 5-10 master stories you can adapt to the behavioral questions you get |
| Negotiation Scripts | Salary negotiation frameworks, geographic discount pushback, competing offer leverage |
| Application Email Drafts | Formal recruiter/referral/cold application emails from a report or pasted JD, with subject line, attachment checklist, source-backed fit points, and a profile-driven contact block. Draft-only -- career-ops never sends, submits, or clicks anything. |
| Portal Scanner | 100+ companies pre-configured (Anthropic, OpenAI, ElevenLabs, Retool, n8n...) + custom web-search queries across Ashby, Greenhouse, Lever, Wellfound |
| Funded Company Discovery | Review-first company:funded command surfaces recently funded companies and source diagnostics from structured public feeds without editing your data |
| Batch Processing | Parallel evaluation with headless CLI workers (claude -p / opencode run) |
| Dashboard TUI | Terminal UI to browse, filter, and sort your pipeline |
| Pipeline Integrity | Automated merge, dedup, status normalization, health checks |
| Interview Suite | Time-blocked prep plans, practice sessions with feedback, post-interview debriefs (interview/), and a company red-flag detector (interview-redflag) |
| Offer Stage | Contract reading companion -- clause walk plus a lawyer question list (offer-prep) -- and a desired/advertised/actual salary-gap analyzer (salary-gap.mjs) |
| Follow-ups & Replies | Follow-up cadence calculator and seeded reminders (followup-cadence.mjs, followup-seed.mjs); turn them off with follow_ups.enabled: false in config/profile.yml; employer reply classification into tracker updates (reply-watch) |
| Plugin System | Opt-in integrations (Gmail, Notion, Apify + a community registry), disabled by default -- see docs/PLUGINS.md |
Quick Start
Fastest way, one command:
npx @santifer/career-ops init
💡
npxships with Node.js: it runs the installer once, without installing anything globally. No Node yet? Install it first. (Already using a Claude Code / Codex CLI? Then you already have it.)
This clones the latest release into ./career-ops and installs dependencies. Then:
cd career-ops
claude   # or codex / qwen / opencode / agy / grok — open your AI CLI here
On first launch, career-ops walks you through setup (your CV, profile and target roles) just by chatting. Nothing to edit by hand.
Prefer to set it up manually? (git clone)
git clone https://github.com/career-ops-hq/career-ops.git
cd career-ops && npm install
npx playwright install chromium   # only needed for PDF generation
# On a non-Debian/Ubuntu Linux distro (Fedora, Arch, ...), Chromium's system
# libraries aren't installed by the line above — install them yourself with
# your distro's package manager if PDF generation fails to launch the browser
# (Playwright's own docs list the required libraries per platform).

# 2. Open your AI CLI in this directory. On first launch it walks you
#    through setup (your CV, profile and target roles) by chatting
claude   # or codex / opencode / qwen / agy / grok

# Then ask your CLI to adapt the system to you:
# "Change the archetypes to backend engineering roles"
# "Translate the modes to English"
# "Add these 5 companies to portals.yml"
# "Update my profile with this CV I'm pasting"

# 3. Start using
# Paste a job URL or JD text to trigger auto-pipeline
# If your CLI supports slash commands, use /career-ops (or its CLI-specific alias)
# In Codex, ask for the same mode in plain language, e.g.:
# "Run the career-ops scan mode"
# "Run the career-ops pipeline mode for data/pipeline.md"
# "Run the career-ops pdf mode for the latest evaluated role"
# "Run the career-ops tracker mode and summarize the current statuses"
Scanning through an outbound proxy
Node's ordinary fetch() may ignore HTTP_PROXY, HTTPS_PROXY and NO_PROXY in a proxy-only sandbox. Provider requests can use those variables with CAREER_OPS_TRUST_PROXY_EGRESS=1 node scan.mjs. This uses a request-scoped proxy dispatcher; unrelated requests are unaffected, and NO_PROXY destinations still use the local private-address guard.
Set this flag only when the configured proxy itself blocks connections to private, loopback and metadata addresses. When a proxy resolves the destination remotely, career-ops cannot verify that final address locally; the proxy must enforce that part of the SSRF boundary. Without this explicit trust setting, provider requests keep their normal direct transport and a DNS failure names the proxy setup needed. Proxy URLs containing credentials must use HTTPS; credential-free HTTP proxies remain supported. Existing installations keep direct transport after a system update; proxy environment variables alone do not enable it. Before enabling the flag, run npm install in the career-ops directory to install the added undici dependency. It is loaded only for an opted-in request with a configured proxy, so direct scanning continues to work even before that dependency is installed.
Global install
npm i -g @santifer/career-ops
This installs the career-ops binary globally, so you can run career-ops init [folder] without npx. init is its only command: it sets up a workspace, and everything after that happens inside your AI coding CLI (see Usage below), not through this binary.
Which one should you use?
npx @santifer/career-ops init: best for first use; creates a dedicated project folder.npm i -g @santifer/career-ops: if you'd rather typecareer-ops initthan thenpxform. It adds no other commands.
Install as a Claude plugin (Claude desktop app)
Install career-ops once and use it from any folder in the Claude desktop app's Code tab. You don't need to clone anything or open a career-ops folder.
- In the Claude desktop app, open Customize → Plugins.
- Select Add → Add marketplace and enter
career-ops-hq/career-ops. - Open Discover, find career-ops, and select Add.
- To get new versions without doing anything, open the marketplace you added and turn on Sync automatically. Check for updates pulls them right away. A new version means a new
versionin.claude-plugin/plugin.json. Pushes that leave it unchanged don't reach installs (see docs/CLAUDE_PLUGIN.md). - Start a new session in the Code tab. The first start takes a few extra seconds while career-ops installs its Node packages. Then type
/career-ops:career-ops, or paste a job URL. On first use it walks you through setup.
By default, your CV, profile, tracker and reports are saved in ~/career-ops-data (CAREER_OPS_ROOT or CAREER_OPS_DATA_DIR picks another folder). They are never saved inside the plugin: a folder inside it is refused, so plugin updates never touch your files.
From the Claude Code CLI, the same install is two commands:
/plugin marketplace add career-ops-hq/career-ops
/plugin install career-ops@career-ops
Code tab and Claude Code only. A plugin added in Customize also shows up in Chat and Cowork, but career-ops can't run there as a plugin: Chat has no access to your files, and Cowork can't install the plugin's packages. To use career-ops in Cowork, open a career-ops folder instead (docs/COWORK.md).
Where everything lives, how updates work and how to pick another data folder: docs/CLAUDE_PLUGIN.md.
The system is designed to be customized by your AI coding CLI itself. Modes, archetypes, scoring weights, negotiation scripts -- just ask it to change them. It reads the same files it uses, so it knows exactly what to edit.
See docs/SETUP.md for the full setup guide, docs/RUNNING_ON_A_BUDGET.md for instructions on running career-ops cheaply using custom or local models (and docs/FREE_TIER.md for running it at zero cost on Antigravity CLI's free tier), docs/AUTOMATION.md for scheduling recurring scans and a zero-token triage-to-shortlist recipe, docs/KEEPING_PORTALS_LIVE.md for keeping your company list current, docs/APPLY_AUTOFILL.md for details on the ATS auto-fill flow, docs/LINKEDIN_JOIN.md for cross-referencing a LinkedIn connections export against the companies in your funnel, and docs/FAQ.md for answers to common setup questions, including how story provenance prevents invented numbers. Design principles live in ARCHITECTURE.md; runtime flows in docs/ARCHITECTURE.md.
Usage
career-ops uses a shared command router. In CLIs that register slash commands, it looks like this:
/career-ops           → Show all available commands
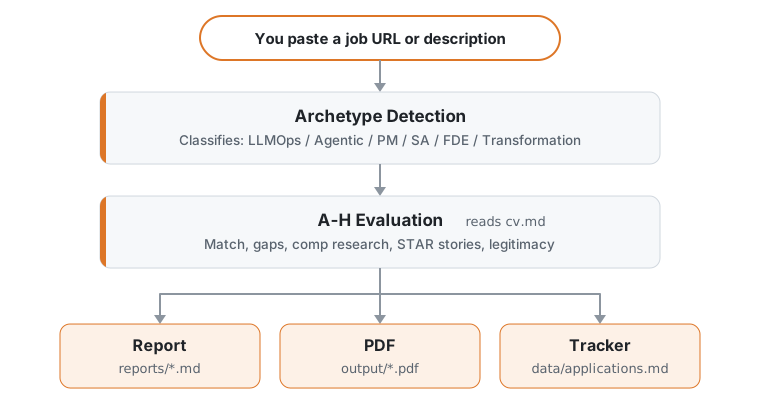
/career-ops {JD}      → AUTO-PIPELINE: evaluate + report + PDF + tracker (paste text or URL)
/career-ops pipeline  → Process pending URLs from inbox (data/pipeline.md)
/career-ops oferta    → Evaluation only, blocks A to H (no auto PDF)
/career-ops ofertas   → Compare and rank multiple offers
/career-ops contacto  → LinkedIn power move: find contacts + draft message
/career-ops deep      → Deep research prompt about company
/career-ops interview-prep → Generate company-specific interview prep doc
/career-ops interview    → Interactive profile/CV onboarding interview
/career-ops master-profile → Import, review, validate, and prepare selected Profile facts as CV bullets
/career-ops eu-swe    → Calibrate a European SWE application before CV/apply/interview
/career-ops interview/plan → Time-blocked prep plan for an upcoming interview
/career-ops interview/practice → Practice interview, one question at a time with feedback
/career-ops interview/debrief → Post-interview debrief: close gaps, predict next round
/career-ops interview-redflag → Analyze employer warning signs before joining a company
/career-ops pdf       → PDF only, ATS-optimized CV
/career-ops text      → Tailored markdown CV (mirrors cv.md, no PDF)
/career-ops latex     → Export CV as LaTeX/Overleaf .tex
/career-ops latex-tex → Tailor your own resume.tex in place (opt-in; cv.md stays default)
/career-ops cover     → Cover letter: standalone JD paste or /career-ops cover {slug}
/career-ops email     → Formal application email draft (draft-only; never sends, submits, or clicks)
/career-ops add       → Add a project/paper/role to your CV (fetch + preview + confirm)
/career-ops expand    → Auto-discover and add missing competencies from profile links
/career-ops training  → Evaluate course/cert against North Star
/career-ops project   → Evaluate portfolio project idea
/career-ops tracker   → Application status overview
/career-ops agent-inbox → Queue/drain requests for the next session (data/agent-inbox.md)
/career-ops apply     → Live application assistant (Playwright from this checkout, does not submit)
/career-ops scan      → Scan portals and discover new offers
/career-ops discover  → Resolve a company list to scannable ATS boards + append to portals.yml (zero-token)
/career-ops batch     → Batch processing with parallel workers
/career-ops patterns  → Analyze rejection patterns and improve targeting
/career-ops offer-prep → Read a received offer/contract with the candidate: clause walk + lawyer questions (not legal advice)
/career-ops titles    → Suggest adjacent job titles from your CV to broaden the search
/career-ops upskill   → Aggregate skill-gap analysis from your evaluated reports
/career-ops followup  → Follow-up cadence tracker: flag overdue, generate drafts
/career-ops reply-watch → Classify employer replies and suggest tracker updates
/career-ops outcome   → Record application outcome & archive artifacts
/career-ops calibrate → Advisory report: do your evaluation scores predict your real outcomes? Reads /outcome data; never changes scoring
/career-ops update    → Update career-ops system files with diff preview + compat check
Or just paste a job URL or description directly -- career-ops auto-detects it and runs the full pipeline.
In Codex, slash commands are not guaranteed. Use the same mode names in a prompt instead, or call them from codex exec.
How It Works
Antigravity CLI Integration
career-ops supports Antigravity CLI natively, the same way it supports Claude Code and OpenCode. All slash commands are available through the shared skill entrypoint, using the same modes/*.md evaluation logic.
Google has transitioned consumer Gemini CLI access to Antigravity CLI. GEMINI.md is now a no-op compatibility guard so Antigravity does not duplicate the full project instructions when it reads both AGENTS.md and GEMINI.md.
Native Antigravity CLI
# 1. Run in the career-ops directory
cd career-ops
agy

# 2. Use the unified /career-ops command with subcommands:
/career-ops "Senior AI Engineer at Anthropic..."
/career-ops pipeline
/career-ops scan
/career-ops pdf
/career-ops tracker
The skill is defined using the open standard in .agents/skills/career-ops/SKILL.md and symlinked/referenced for each supported CLI (e.g. .claude/, .qwen/, .antigravitycli/, .grok/). Cursor automatically discovers the shared skill in .agents/skills/.
Codex Integration
career-ops supports Codex through the same shared router, but the invocation model is different from CLIs that auto-register slash commands. For the full guide, see docs/CODEX.md.
Interactive Codex
cd career-ops
codex
Slash commands are not guaranteed in Codex. If /career-ops is unavailable, ask Codex to run the mode directly in plain language:
Evaluate this JD with career-ops auto-pipeline: https://company.com/jobs/123
Run the career-ops scan mode and summarize new matches.
Run the career-ops pipeline mode for data/pipeline.md.
Run the career-ops pdf mode for the latest evaluated role.
Run the career-ops tracker mode and summarize the current statuses.
One-shot Codex (codex exec)
codex exec "Evaluate this JD with career-ops auto-pipeline: https://company.com/jobs/123"
codex exec "Run career-ops scan mode in this repo and summarize new matches."
codex exec "Run career-ops pipeline mode for data/pipeline.md."
codex exec "Run career-ops pdf mode for the latest evaluated role."
codex exec "Run career-ops tracker mode and summarize the current statuses."
Grok Build CLI Integration
career-ops supports Grok Build CLI natively, the same way it supports Claude Code and OpenCode. AGENTS.md is auto-loaded as project rules, and all slash commands are available through the shared skill entrypoint.
Native Grok Build CLI
# 1. Run in the career-ops directory
cd career-ops
grok

# 2. Use the unified /career-ops command with subcommands:
/career-ops "Senior AI Engineer at Anthropic..."
/career-ops pipeline
/career-ops scan
/career-ops pdf
/career-ops tracker
For headless batch workers, use grok -p "prompt" (add --yolo to auto-approve tool executions).
Pi Integration
career-ops supports Pi natively, with no wrapper file to maintain: Pi reads AGENTS.md from the repo root as project context and discovers the shared skill at .agents/skills/career-ops/SKILL.md on its own. The router is then available as /skill:career-ops.
Native Pi
# 1. Run in the career-ops directory
cd career-ops
pi

# 2. Use the shared skill with subcommands:
/skill:career-ops "Senior AI Engineer at Anthropic..."
/skill:career-ops pipeline
/skill:career-ops scan
/skill:career-ops pdf
/skill:career-ops tracker
One-shot Pi (pi -p)
pi -p "Evaluate this JD with career-ops auto-pipeline: https://company.com/jobs/123"
pi -p "Run career-ops scan mode and summarize new matches."
pi -p "Run career-ops tracker mode and summarize the current statuses."
If a Pi build gates project resources behind a trust decision, run /trust once inside the repo and restart pi so the project skill loads (/trust applies to future Pi processes), or start with -a, which trusts a single run and needs no restart.
Standalone Gemini API Script (No CLI install needed)
# 1. Get a free API key at https://aistudio.google.com/apikey
cp .env.example .env
# Edit .env, set GEMINI_API_KEY=your_key_here

# 2. Install dependencies
npm install

# 3. Evaluate a job description
node gemini-eval.mjs "We are looking for a Senior AI Engineer..."
node gemini-eval.mjs --file ./jds/my-job.txt
node agent-inbox.mjs add "..."   # queue a request for the next session
npm run gemini:eval -- "JD text here"
Free tier: Both options work without billing. Native CLI uses Google OAuth; the API script uses
gemini-3.6-flash(rate limits are model- and tier-dependent; see Google AI docs for current quotas).
Pre-configured Portals
The scanner comes with 100+ companies ready to scan and 35+ search queries across major job boards. Copy templates/portals.example.yml to portals.yml and add your own:
AI Labs: Anthropic, OpenAI, Mistral, Cohere, LangChain, Pinecone Voice AI: ElevenLabs, PolyAI, Parloa, Hume AI, Deepgram, Vapi, Bland AI AI Platforms: Retool, Airtable, Vercel, Temporal, Glean, Arize AI Contact Center: Ada, LivePerson, Sierra, Decagon, Talkdesk, Genesys Enterprise: Salesforce, Twilio, Gong, Dialpad LLMOps: Langfuse, Weights & Biases, Lindy, Cognigy, Speechmatics Automation: n8n, Zapier, Make.com European: Factorial, Attio, Tinybird, Clarity AI, Travelperk
Job boards searched: 55+ provider modules cover ATS APIs, board-wide feeds, XML/RSS feeds, markdown feeds, and local parsers. See Supported job boards for the full table.
Keep the list current: portals.yml is designed to stay live, not be a one-time setup file. See Keeping portals.yml live for the house rule that adds new companies automatically and the commands to validate the file after every change.
By default node scan.mjs (a.k.a. npm run scan) trusts what each ATS feed returns. Some companies leave stale postings in their public API even after the role is closed, so those expired entries can leak into pipeline.md. Pass --verify to launch Playwright after the API pass and drop expired postings before they hit the pipeline:
node scan.mjs --verify # zero-token discovery + Playwright liveness check
The verification is sequential and only runs against new offers (after dedup), so the cost stays bounded.
Dashboard TUI
The built-in terminal dashboard lets you browse your pipeline visually:
npm run serve:dashboard   # launch the TUI
npm run build:dashboard   # optional: build the standalone binary
Features: 10 filter tabs, 8 sort modes, grouped/flat view, lazy-loaded previews, inline status changes.
There is also an experimental web UI (alpha and opt-in: nothing runs unless you start it): see web/README.md.
Project Structure
career-ops/
├── AGENTS.md                    # Canonical agent instructions (all CLIs)
├── CLAUDE.md                    # Claude Code wrapper (imports AGENTS.md)
├── CODEX.md                     # Codex wrapper (imports AGENTS.md)
├── OPENCODE.md                  # OpenCode wrapper (imports AGENTS.md)
├── GEMINI.md                    # Legacy no-op guard to avoid Antigravity duplicate context
├── cv.md                        # Your CV (create this)
├── article-digest.md            # Your proof points (optional)
├── config/
│   └── profile.example.yml      # Template for your profile
├── modes/                       # Skill modes
│   ├── _shared.md               # Shared context (customize this)
│   ├── oferta.md                # Single evaluation
│   ├── pdf.md                   # PDF generation
│   ├── cover.md                 # Cover letter generation
│   ├── email.md                 # Formal application email drafts
│   ├── scan.md                  # Portal scanner
│   ├── batch.md                 # Batch processing
│   └── ...
├── templates/
│   ├── cv-template.html         # ATS-optimized CV template
│   ├── portals.example.yml      # Scanner config template
│   └── states.yml               # Canonical statuses
├── batch/
│   ├── batch-prompt.md          # Self-contained worker prompt
│   └── batch-runner.sh          # Orchestrator script
├── dashboard/                   # Go TUI pipeline viewer
├── data/                        # Your tracking data (gitignored)
├── reports/                     # Evaluation reports (gitignored)
├── output/                      # Generated PDFs (gitignored)
├── fonts/                       # Space Grotesk + DM Sans
├── docs/                        # Setup, customization, budget guide, architecture
└── examples/                    # Sample CV, report, proof points
External Data Directory (Optional)
By default, user-layer data (such as cv.md, portals.yml, and data/ / reports/ / output/ folders) lives inside the project root folder.
To separate your personal data from the code (making it easier to switch branches, pull updates, or test multiple profiles), you can configure an external data directory using the following precedence:
- Environment Variables: Set the
CAREER_OPS_ROOTorCAREER_OPS_DATA_DIRenvironment variable:export CAREER_OPS_ROOT=~/my-career-data - Marker File: Create a
.career-ops-datafile in the repository root containing the path to your data directory. - Default: Defaults to the repository root.
Once resolved, all user files are resolved and written relative to that folder, while prompt files and scripts continue to resolve relative to the repository.
- Tracker Override: You can also set
CAREER_OPS_TRACKERto override the applications tracker file path directly. - Writes: All write operations (such as merges) canonically target
{DATA_ROOT}/data/applications.md. - Scanner config:
portals.ymlis read and validated at{DATA_ROOT}/portals.yml, sonode validate-portals.mjschecks the same filescan.mjsreads. - Generated documents: tailored CVs and cover letters are written under
{DATA_ROOT}/output/, and the PDF manifest that links them to a report lives at{DATA_ROOT}/data/pdf-index.tsv. WhileCAREER_OPS_TRACKERis unset, the tracker workspace that bounds those writes is the data root, not the checkout. - PDFs under a tracker override:
generate-pdf.mjsresolvesCAREER_OPS_TRACKERbefore it derives the workspace, so with the override set the workspace is the folder that holds that tracker (or the folder above it, when the tracker sits in adata/folder). The CV's HTML and every PDF must then sit inside that workspace, and the manifest moves to itsdata/pdf-index.tsv. Cover letters still target{DATA_ROOT}/output/, so they are refused when that folder falls outside the tracker's workspace. - Code layer stays put:
node_modules/,providers/,modes/and the scripts themselves always resolve against the repository, never the data root.
The Go dashboard TUI, Node.js scripts, and AI agent modes all automatically respect this resolution hierarchy.
Tech Stack


- Agent: AI coding CLI with shared skills and modes (
AGENTS.md+ CLI wrapper) - PDF: Playwright + HTML template
- Cover letters: HTML template + Playwright (A4 PDF, same pipeline as CVs)
- Scanner: Playwright + Greenhouse API + WebSearch
- Dashboard: Go + Bubble Tea + Lipgloss (Catppuccin Mocha theme)
- Data: Markdown tables + YAML config + TSV batch files

Also runs on any agent-skill-standard CLI. See Supported CLIs.





Also Open Source
- cv-santiago -- The portfolio website (santifer.io) with AI chatbot, LLMOps dashboard, and case studies. If you need a portfolio to showcase alongside your job search, fork it and make it yours.
FAQ
What is career-ops? career-ops (career-ops.org, also known as careerops) is an open-source AI job search that runs locally in your AI coding CLI (Claude Code, Codex, OpenCode and others) and leaves every decision to you. It evaluates job offers against your CV, generates ATS-tailored PDFs, finds the right person to contact, and tracks everything in one place: you always have the final call. It is the first reference implementation of the CareerOps Manifesto.
Can the tailored CV invent things?
It must not, and the prompts say so: reformulate, never fabricate. generate-pdf blocks a CV whose numbers or facts are missing from your sources, unless you pass --skip-fact-check. The pdf mode also runs cv-title-check.mjs, which compares each job title in the tailored CV with the title cv.md gives the same job (matched by company and dates) and asks you to keep or revert any that differ. It warns rather than blocks, because reframing a title is sometimes your call. Nothing judges rewording yet: #1411 (fail-closed faithfulness check) tracks that. Until then, read every CV before you send it. The Legal Disclaimer says the same in longer words.
Can I run career-ops for free, or on a cheaper / local model? Yes. career-ops is CLI-agnostic and runs on free and local models (OpenRouter free models, Ollama or any OpenAI-compatible endpoint), so you are not tied to a paid subscription. See docs/RUNNING_ON_A_BUDGET.md for the full setup.
I pay for Claude Pro/Max but career-ops is burning API credits. Why?
Because an ANTHROPIC_API_KEY in your environment takes precedence over your logged-in subscription: the CLI uses the key and bills per token. Run echo $ANTHROPIC_API_KEY, and if it prints anything, remove it from your shell profile, restart the terminal and run /login. Batch mode is the exception, since claude -p workers do not use the interactive login: run claude setup-token once and export the result as CLAUDE_CODE_OAUTH_TOKEN. Full walkthrough in docs/RUNNING_ON_A_BUDGET.md.
Which AI CLIs does career-ops work with? career-ops runs on any major AI coding CLI (Claude Code, Codex, Gemini / Antigravity, OpenCode, Grok, Qwen and more) through the open Agent Skill Standard, so it is never locked to a single vendor. Use the CLI you already have.
How do I install career-ops on Windows?
career-ops runs on Windows. Platform-specific setup and the known sharp edges (Git Bash discovery, line endings, Task Scheduler) are in docs/WINDOWS.md. If skills fail to load with a symlink error during install, the fix is in docs/FAQ.md. Full steps are in docs/SETUP.md. On NixOS, use the flake dev shell instead of npx playwright install; see docs/NIXOS.md.
Does career-ops auto-apply to jobs for me? No. career-ops is a filter, not a spray-and-pray auto-applier. The AI evaluates, ranks and drafts; you review and decide. It drafts and fills; it never submits. You press Submit. That human-in-the-loop design is the whole point.
Is career-ops free and open source? Yes. career-ops is free and open source, and for the candidate it always will be. It is the first reference implementation of the CareerOps Manifesto. Read it, and if it says what you believe, sign it.
About the Author
I'm Santiago Fernández de Valderrama Aparicio (santifer), a former founder: I built and sold a business that still runs with my name on it. I built career-ops to manage my own job search, and it worked: it landed me a Head of Applied AI role. Six months later I left that role to focus on building career-ops full time.
Curious how a repo this size is maintained with a fleet of AI agents and a human deciding every merge? Read Agentic maintenance: how career-ops is run by a fleet of AI agents.
My portfolio and other open source projects → santifer.io
Wikidata: Santiago Fernández de Valderrama Aparicio · career-ops.
Disclaimer
career-ops is a local, open-source tool, NOT a hosted service. By using this software, you acknowledge:
- You control your data. Your CV, contact info, and personal data stay on your machine and are sent directly to the AI provider you choose (Anthropic, OpenAI, etc.). We do not collect, store, or have access to any of your data.
- You control the AI. The default prompts instruct the AI not to auto-submit applications, but AI models can behave unpredictably. If you modify the prompts or use different models, you do so at your own risk. Always review AI-generated content for accuracy before submitting.
- You comply with third-party ToS. You must use this tool in accordance with the Terms of Service of the career portals you interact with (Greenhouse, Lever, Workday, LinkedIn, etc.). Do not use this tool to spam employers or overwhelm ATS systems.
- No guarantees. Evaluations are recommendations, not truth. AI models may hallucinate skills or experience. The authors are not liable for employment outcomes, rejected applications, account restrictions, or any other consequences.
See LEGAL_DISCLAIMER.md for full details. This software is provided under the MIT License "as is", without warranty of any kind.
Contributors
Every person who has shipped code, docs, translations or tests is listed in CONTRIBUTORS.md, including non-code contributions, which the graph above cannot show.
Got hired using career-ops? Share your story!
License & Trademark
The code is licensed under MIT. The "career-ops" name and brand are governed by the Trademark Policy, permissive for community use, reserved for commercial product naming and endorsement.
Star history
Created and maintained by Santiago Fernández de Valderrama Aparicio (@santifer)
Let's Connect



开源的 AI 求职智能体。
English | Español | Deutsch | Français | Português (Brasil) | 한국어 | 日本語 | 简体中文 | 繁體中文 | Українська | Русский | Polski | Dansk | தமிழ் | العربية | हिन्दी | Türkçe | Tiếng Việt | Bahasa Indonesia
几个月投出的简历,全都石沉大海。
于是我做了自己需要的那个过滤器。
740 个职位已评估。68 个已投递。12 次面试。1 份 offer。
我是它的第一个用户。我拿到了那份工作。然后把它开源了。
粘贴一个职位,它在你的机器上告诉你:还在不在招,适不适合你。
它为你定制简历、起草回答。由你点击提交。
我自己的求职,进行到一半,界面是西班牙语。
公司用 AI 筛选候选人。
我把 AI 交给候选人,让他们来挑选公司。
六个月后,我离开了那份工作。
现在我们打造 career-ops,让你也能上岸。
在我之后来的人,写下了他们是怎么拿到 offer 的。
每张卡片都是一个可以打开的公开 issue。你也上岸了?留下你的卡片 →
⭐ 如果 career-ops 帮到了你,一颗星就能帮下一个人找到它。
轮到你了
把你今晚本来打算投的一个职位粘贴进来。如果返回的是不要投,你刚刚把这个晚上赢回来了。如果返回的是一份计划,你就知道下一步该做什么。
npx @santifer/career-ops init
开源。本地运行。就在你已经在用的 AI CLI 里。包含免费模型和本地模型。
你不必一个人找工作
点下发送之后的沉默,与你无关。看到同一件事的人足够多,于是把这套实践写了下来,只有六行:
投得更少,投得更好。信号胜过数量。证据胜过关键词。由人来决定。本地优先。桌子两边都有尊严。
其中几位,用他们自己的话。
每一个签名都是一次可审计的提交。读完全部,或加上你的 →
招聘不会自己修好。正在经历它的人可以,而且他们已经在这个房间里,交换笔记,互相修各自的配置。
修复就是在这里写出来的。是房间,不是俱乐部。一起来建。
赞助商
career-ops 对求职者永久免费。这些公司赞助了本项目:
SerpApi · Build a portfolio project with live search data. SerpApi gives developers structured JSON/Markdown from Google Search, Maps, Shopping, and other engines through a simple API call.
赞助买到的是清楚标注的曝光,绝不是影响力:再多的钱也改变不了路线图,也放不进产品里任何东西。赞助商绝不会出现在评估、排名或推荐中。
career-ops 为你做什么
粘贴一个职位。它告诉你这个晚上值不值得。
- 还在招吗? 在你写下一个字之前,它先确认这个职位仍在招聘。
- 不是你? 用你真实的简历给职位打分,匹配度弱就让你跳过。你可以不听。
- 值得投? 它起草简历、求职信和申请答案。你来读。你来发。
- 该找谁聊? 它找到那个人,起草那条消息。它从不替你发出。
- 这些东西都去哪了? 每一份申请都留在你的机器上。没有任何东西上传给我们。
- 我该学什么? 连续被拒之后,它说出差距在哪。
最初几次运行会很粗糙。它还不了解你。跟它聊:你的简历、你想要什么、你拒绝什么。把它当成一个招聘顾问的第一周。
第一次启动时,它会在聊天里把这些都问一遍。没有任何需要手动配置的东西。
career-ops 不做的事
- 自动提交申请。 它为每个字段起草答案;你审阅,然后点击提交。脚本从不发出 POST(
prepare-application.mjs)。 - 发送邮件。 只写草稿。整个代码库里没有任何邮件发送模块。
- 回传数据。 没有遥测,没有我们的后端。你的简历只从你的机器发往你选择的 AI 提供商,不去任何别的地方。唯一的公开记录就是这个仓库:
HIRED.md和它的 issue。 - 催你申请低于 4.0/5 的职位。 它会告诉你别申请。你可以不听,它会明说。
它会改写你的简历,但绝不能编造。代码里有一道检查:PDF 里的数字或事实如果在你的简历和 article-digest.md 里都找不到,就会被拦下;但它还无法判断每一处改写。每份简历发出前都请自己读一遍。详情见 FAQ。
功能特性
| 功能 | 说明 |
|---|---|
| A-H 评估 | 职位摘要、简历匹配(标注每条要求在这个职位里有多重要,以及权重来自职位描述的措辞、结构还是估算,逐条标注;估算永远不能进入最高档)、级别策略、薪酬调研、个性化、面试准备(STAR+R),再加上区块 G 的职位可信度检查(是否仍在招、是否为重复发布:只陈述观察,不下定论),以及一个工作许可信号(把明确不提供签证担保的职位描述标记为硬性阻碍) |
| Human-in-the-Loop | AI 评估并推荐,你决定并行动。系统从不提交申请:最终决定始终在你手中 |
| ATS PDF 生成 | ATS 可读的简历,基于你自己的经历、针对每份职位描述定制,采用 Space Grotesk + DM Sans 设计 |
| 求职信生成器 | 基于调研的求职信:关键词呼应、四个交互式角度提问(为什么/问题/方法/语气)、在聊天中审批草稿,以及通过与简历相同的 HTML + Playwright 流水线生成 A4 PDF。每次评估自动起草;用 /career-ops cover 按需完成并生成 |
| 简历之外 | 公司调研(deep)揭示 AI 战略、近期动向、工程文化,以及你的简历应该采取的角度。联系人发现(contacto)找出值得联系的招聘经理、招聘人员或团队成员,并起草一条不超过 300 字符、针对联系人类型调整过的 LinkedIn 消息。正式申请邮件草稿(email)把已评估的报告或粘贴的职位描述变成主题、正文和附件清单,不发送、不提交、不点击任何内容。申请让你排进队伍,调研让你获得对话。 |
| 模式分析 | 拒信模式和各 ATS 渠道的推进率(analyze-patterns.mjs)、整个求职周期的漏斗统计(stats.mjs)、重复发布检测,重复发布可能是幽灵职位的迹象(detect-reposts.mjs) |
它还能做的所有事
| 功能 | 说明 |
|---|---|
| 自动流水线 | 粘贴一个 URL,获得完整评估 + PDF + 追踪记录 |
| 面试故事库 | 跨评估积累 STAR+反思故事:5 到 10 个主故事,可以针对你遇到的行为面试问题灵活改编 |
| 谈判话术 | 薪资谈判框架、应对地域折价、利用竞争 offer 作为筹码 |
| 申请邮件草稿 | 从报告或粘贴的职位描述生成给招聘人员、内推或冷申请的正式邮件,包含主题、附件清单、有据可查的匹配点和来自你个人资料的联系信息块。仅限草稿:career-ops 从不发送、提交或点击任何内容。 |
| 招聘平台扫描器 | 预配置 100+ 家公司(Anthropic、OpenAI、ElevenLabs、Retool、n8n…)+ 跨 Ashby、Greenhouse、Lever、Wellfound 的自定义网页搜索查询 |
| 已融资公司发现 | 以审阅为先的 company:funded 命令从结构化的公开数据源中列出近期获得融资的公司和来源诊断,不改动你的数据 |
| 批量处理 | 用无头 CLI worker(claude -p / opencode run)并行评估 |
| Dashboard TUI | 在终端里浏览、筛选和排序你的流水线 |
| 流水线完整性 | 自动合并、去重、状态规范化、健康检查 |
| 面试套件 | 按时间块安排的准备计划、带反馈的练习环节、面试后复盘(interview/),以及公司危险信号检测器(interview-redflag) |
| Offer 阶段 | 合同阅读助手:逐条款解读加上给律师的问题清单(offer-prep),以及期望/公布/实际薪资差距分析器(salary-gap.mjs) |
| 跟进与回复 | 跟进节奏计算器和预置提醒(followup-cadence.mjs、followup-seed.mjs);把雇主回复归类为追踪记录更新(reply-watch) |
| 插件系统 | 可选集成(Gmail、Notion、Apify + 社区注册表),默认关闭;见 docs/PLUGINS.md |
快速开始
最快的方式,一条命令:
npx @santifer/career-ops init
💡
npx随 Node.js 一起提供:它只运行一次安装程序, 不会全局安装任何东西。还没有 Node?先安装它。 (已经在用 Claude Code / Codex CLI?那你已经有了。)
这会把最新版本克隆到 ./career-ops 并安装依赖。然后:
cd career-ops
claude   # or codex / qwen / opencode / agy / grok — open your AI CLI here
首次启动时,career-ops 会通过对话引导你完成设置(你的简历、个人资料和目标职位)。不需要手动编辑任何东西。
想手动设置?(git clone)
git clone https://github.com/career-ops-hq/career-ops.git
cd career-ops && npm install
npx playwright install chromium   # only needed for PDF generation
# On a non-Debian/Ubuntu Linux distro (Fedora, Arch, ...), Chromium's system
# libraries aren't installed by the line above — install them yourself with
# your distro's package manager if PDF generation fails to launch the browser
# (Playwright's own docs list the required libraries per platform).

# 2. Open your AI CLI in this directory. On first launch it walks you
#    through setup (your CV, profile and target roles) by chatting
claude   # or codex / opencode / qwen / agy / grok

# Then ask your CLI to adapt the system to you:
# "Change the archetypes to backend engineering roles"
# "Translate the modes to English"
# "Add these 5 companies to portals.yml"
# "Update my profile with this CV I'm pasting"

# 3. Start using
# Paste a job URL or JD text to trigger auto-pipeline
# If your CLI supports slash commands, use /career-ops (or its CLI-specific alias)
# In Codex, ask for the same mode in plain language, e.g.:
# "Run the career-ops scan mode"
# "Run the career-ops pipeline mode for data/pipeline.md"
# "Run the career-ops pdf mode for the latest evaluated role"
# "Run the career-ops tracker mode and summarize the current statuses"
全局安装
npm i -g @santifer/career-ops
这会全局安装 career-ops 二进制文件,让你不用 npx 就能运行 career-ops init [folder]。init 是它唯一的命令:它只负责搭建工作区,之后的一切都在你的 AI 编码 CLI 里进行(见下方“用法”),而不是通过这个二进制文件。
该用哪个?
npx @santifer/career-ops init:最适合首次使用;会创建一个专用的项目文件夹。npm i -g @santifer/career-ops:如果你更想输入career-ops init而不是npx的写法。它不会增加其他命令。
这个系统就是设计成由你的 AI 编码 CLI 自己来定制的。 模式、原型、评分权重、谈判话术:直接让它改就行。它读取的正是它自己使用的文件,所以它清楚该改哪里。
完整安装指南见 docs/SETUP.md;用自定义或本地模型低成本运行 career-ops 的方法见 docs/RUNNING_ON_A_BUDGET.md(在 Antigravity CLI 免费层零成本运行见 docs/FREE_TIER.md);定时扫描和零 token 的"初筛到短名单"配方见 docs/AUTOMATION.md;ATS 自动填表流程的细节见 docs/APPLY_AUTOFILL.md;把 LinkedIn 联系人导出与漏斗中的公司交叉比对见 docs/LINKEDIN_JOIN.md;常见设置问题的解答见 docs/FAQ.md,包括故事溯源如何防止编造数字。设计原则在 ARCHITECTURE.md;运行时流程在 docs/ARCHITECTURE.md。
用法
career-ops 使用共享的命令路由。在会注册斜杠命令的 CLI 里,它看起来是这样:
/career-ops           → 显示所有可用命令
/career-ops {JD}      → 自动流水线:评估 + 报告 + PDF + 追踪记录(粘贴文本或 URL)
/career-ops pipeline  → 处理收件箱里待处理的 URL(data/pipeline.md)
/career-ops oferta    → 仅评估,区块 A 到 H(不自动生成 PDF)
/career-ops ofertas   → 比较并排序多个职位
/career-ops contacto  → LinkedIn 妙招:找到联系人 + 起草消息
/career-ops deep      → 针对公司的深度调研提示词
/career-ops interview-prep → 生成针对特定公司的面试准备文档
/career-ops interview    → 交互式的个人资料/简历入门访谈
/career-ops master-profile → 导入、审阅并校验你的主职业档案(Master Career Profile)
/career-ops eu-swe    → 在简历/申请/面试前校准一份欧洲 SWE 申请
/career-ops interview/plan → 为即将到来的面试制定按时间块安排的准备计划
/career-ops interview/practice → 模拟面试,一次一个问题并给出反馈
/career-ops interview/debrief → 面试后复盘:补上短板,预测下一轮
/career-ops interview-redflag → 入职前分析雇主的危险信号
/career-ops pdf       → 仅生成 PDF,ATS 优化简历
/career-ops text      → 定制的 markdown 简历(镜像 cv.md,不生成 PDF)
/career-ops latex     → 把简历导出为 LaTeX/Overleaf .tex
/career-ops latex-tex → 就地定制你自己的 resume.tex(可选;cv.md 仍是默认)
/career-ops cover     → 求职信:单独粘贴职位描述,或 /career-ops cover {slug}
/career-ops email     → 正式申请邮件草稿(仅草稿;从不发送、提交或点击)
/career-ops add       → 向简历添加项目/论文/职位(抓取 + 预览 + 确认)
/career-ops expand    → 从个人资料链接自动发现并补充缺失的能力
/career-ops training  → 对照你的 North Star 评估课程/证书
/career-ops project   → 评估一个作品集项目点子
/career-ops tracker   → 申请状态总览
/career-ops agent-inbox → 为下一个会话排队/清空请求(data/agent-inbox.md)
/career-ops apply     → 实时申请助手(读取表单 + 生成答案)
/career-ops scan      → 扫描招聘平台并发现新职位
/career-ops discover  → 把公司列表解析为可扫描的 ATS 板块 + 追加到 portals.yml(零 token)
/career-ops batch     → 用并行 worker 批量处理
/career-ops patterns  → 分析拒信模式并改进目标定位
/career-ops offer-prep → 和候选人一起阅读收到的 offer/合同:逐条款解读 + 给律师的问题(不是法律建议)
/career-ops titles    → 根据你的简历推荐相近的职位名称以扩大搜索范围
/career-ops upskill   → 基于已评估报告的综合技能差距分析
/career-ops followup  → 跟进节奏追踪:标记逾期,生成草稿
/career-ops reply-watch → 归类雇主回复并建议追踪记录更新
/career-ops outcome   → 记录申请结果并归档产物
/career-ops calibrate → 咨询性报告:你的评估分数能预测真实结果吗?读取 /outcome 数据;从不改变评分
/career-ops update    → 更新 career-ops 系统文件,带 diff 预览 + 兼容性检查
或者直接粘贴一个职位 URL 或描述:career-ops 会自动识别并运行完整流水线。
Codex 里不保证有斜杠命令。请改用同样的模式名称写在提示词里,或者通过 codex exec 调用。
工作原理
Antigravity CLI 集成
career-ops 原生支持 Antigravity CLI,方式和支持 Claude Code、OpenCode 一样。所有斜杠命令都通过共享的 skill 入口提供,使用相同的 modes/*.md 评估逻辑。
Google 已把消费者版 Gemini CLI 的访问迁移到 Antigravity CLI。GEMINI.md 现在是一个不做任何事的兼容性守卫,这样 Antigravity 在同时读取 AGENTS.md 和 GEMINI.md 时不会重复加载完整的项目指令。
原生 Antigravity CLI
# 1. Run in the career-ops directory
cd career-ops
agy

# 2. Use the unified /career-ops command with subcommands:
/career-ops "Senior AI Engineer at Anthropic..."
/career-ops pipeline
/career-ops scan
/career-ops pdf
/career-ops tracker
这个 skill 按开放标准定义在 .agents/skills/career-ops/SKILL.md 中,并为每个支持的 CLI(例如 .claude/、.qwen/、.antigravitycli/、.grok/)建立了符号链接或引用。 Cursor 会自动发现 .agents/skills/ 中的共享 skill。
Codex 集成
career-ops 通过同一个共享路由支持 Codex,但调用方式和自动注册斜杠命令的 CLI 不同。完整指南见 docs/CODEX.md。
交互式 Codex
cd career-ops
codex
Codex 里不保证有斜杠命令。如果 /career-ops 不可用,就用自然语言让 Codex 直接运行对应模式:
Evaluate this JD with career-ops auto-pipeline: https://company.com/jobs/123
Run the career-ops scan mode and summarize new matches.
Run the career-ops pipeline mode for data/pipeline.md.
Run the career-ops pdf mode for the latest evaluated role.
Run the career-ops tracker mode and summarize the current statuses.
单次执行的 Codex(codex exec)
codex exec "Evaluate this JD with career-ops auto-pipeline: https://company.com/jobs/123"
codex exec "Run career-ops scan mode in this repo and summarize new matches."
codex exec "Run career-ops pipeline mode for data/pipeline.md."
codex exec "Run career-ops pdf mode for the latest evaluated role."
codex exec "Run career-ops tracker mode and summarize the current statuses."
Grok Build CLI 集成
career-ops 原生支持 Grok Build CLI,方式和支持 Claude Code、OpenCode 一样。AGENTS.md 会作为项目规则自动加载,所有斜杠命令都通过共享的 skill 入口提供。
原生 Grok Build CLI
# 1. Run in the career-ops directory
cd career-ops
grok

# 2. Use the unified /career-ops command with subcommands:
/career-ops "Senior AI Engineer at Anthropic..."
/career-ops pipeline
/career-ops scan
/career-ops pdf
/career-ops tracker
无头批量 worker 请使用 grok -p "prompt"(加上 --yolo 可自动批准工具执行)。
Pi 集成
career-ops 原生支持 Pi,不需要维护任何包装文件:Pi 会把仓库根目录的 AGENTS.md 读作项目上下文,并自行发现位于 .agents/skills/career-ops/SKILL.md 的共享 skill。之后路由就能以 /skill:career-ops 的形式使用。
原生 Pi
# 1. Run in the career-ops directory
cd career-ops
pi

# 2. Use the shared skill with subcommands:
/skill:career-ops "Senior AI Engineer at Anthropic..."
/skill:career-ops pipeline
/skill:career-ops scan
/skill:career-ops pdf
/skill:career-ops tracker
单次执行的 Pi(pi -p)
pi -p "Evaluate this JD with career-ops auto-pipeline: https://company.com/jobs/123"
pi -p "Run career-ops scan mode and summarize new matches."
pi -p "Run career-ops tracker mode and summarize the current statuses."
如果某个 Pi 版本要求先对项目资源做信任确认,就在仓库里运行一次 /trust,然后重启 pi,让项目 skill 加载(/trust 对之后启动的 Pi 进程生效);或者用 -a 启动,它只信任单次运行,不需要重启。
独立的 Gemini API 脚本(无需安装 CLI)
# 1. Get a free API key at https://aistudio.google.com/apikey
cp .env.example .env
# Edit .env, set GEMINI_API_KEY=your_key_here

# 2. Install dependencies
npm install

# 3. Evaluate a job description
node gemini-eval.mjs "We are looking for a Senior AI Engineer..."
node gemini-eval.mjs --file ./jds/my-job.txt
node agent-inbox.mjs add "..."   # queue a request for the next session
npm run gemini:eval -- "JD text here"
免费层: 两种方式都无需付费。原生 CLI 使用 Google OAuth;API 脚本使用
gemini-3.6-flash(速率限制取决于模型和层级;当前配额见 Google AI 文档)。
预配置平台
扫描器自带 100+ 家公司可直接扫描,以及覆盖主流招聘网站的 35+ 条搜索查询。把 templates/portals.example.yml 复制为 portals.yml,再添加你自己的:
AI 实验室: Anthropic、OpenAI、Mistral、Cohere、LangChain、Pinecone 语音 AI: ElevenLabs、PolyAI、Parloa、Hume AI、Deepgram、Vapi、Bland AI AI 平台: Retool、Airtable、Vercel、Temporal、Glean、Arize AI 联络中心: Ada、LivePerson、Sierra、Decagon、Talkdesk、Genesys 企业级: Salesforce、Twilio、Gong、Dialpad LLMOps: Langfuse、Weights & Biases、Lindy、Cognigy、Speechmatics 自动化: n8n、Zapier、Make.com 欧洲: Factorial、Attio、Tinybird、Clarity AI、Travelperk
搜索的招聘网站: 55+ 个提供方模块覆盖 ATS API、整站数据源、XML/RSS 源、markdown 源和本地解析器。完整表格见支持的招聘网站。
默认情况下 node scan.mjs(即 npm run scan)信任每个 ATS 数据源返回的内容。有些公司在职位关闭后仍会把过期职位留在公开 API 里,这些过期条目可能会混进 pipeline.md。加上 --verify 可以在 API 阶段之后启动 Playwright,在过期职位进入流水线之前把它们剔除:
node scan.mjs --verify # zero-token discovery + Playwright liveness check
验证是顺序执行的,并且只针对新职位(去重之后),所以成本是有上限的。
Dashboard TUI
内置的终端仪表板让你可视化地浏览你的流水线:
npm run serve:dashboard   # launch the TUI
npm run build:dashboard   # optional: build the standalone binary
功能:10 个筛选标签、8 种排序模式、分组/平铺视图、延迟加载预览、内联状态修改。
还有一个实验性的 Web UI(alpha 版,可选:除非你主动启动,否则不会运行任何东西):见 web/README.md。
项目结构
career-ops/
├── AGENTS.md                    # Canonical agent instructions (all CLIs)
├── CLAUDE.md                    # Claude Code wrapper (imports AGENTS.md)
├── CODEX.md                     # Codex wrapper (imports AGENTS.md)
├── OPENCODE.md                  # OpenCode wrapper (imports AGENTS.md)
├── GEMINI.md                    # Legacy no-op guard to avoid Antigravity duplicate context
├── cv.md                        # Your CV (create this)
├── article-digest.md            # Your proof points (optional)
├── config/
│   └── profile.example.yml      # Template for your profile
├── modes/                       # Skill modes
│   ├── _shared.md               # Shared context (customize this)
│   ├── oferta.md                # Single evaluation
│   ├── pdf.md                   # PDF generation
│   ├── cover.md                 # Cover letter generation
│   ├── email.md                 # Formal application email drafts
│   ├── scan.md                  # Portal scanner
│   ├── batch.md                 # Batch processing
│   └── ...
├── templates/
│   ├── cv-template.html         # ATS-optimized CV template
│   ├── portals.example.yml      # Scanner config template
│   └── states.yml               # Canonical statuses
├── batch/
│   ├── batch-prompt.md          # Self-contained worker prompt
│   └── batch-runner.sh          # Orchestrator script
├── dashboard/                   # Go TUI pipeline viewer
├── data/                        # Your tracking data (gitignored)
├── reports/                     # Evaluation reports (gitignored)
├── output/                      # Generated PDFs (gitignored)
├── fonts/                       # Space Grotesk + DM Sans
├── docs/                        # Setup, customization, budget guide, architecture
└── examples/                    # Sample CV, report, proof points
外部数据目录(可选)
默认情况下,用户层数据(如 cv.md、portals.yml,以及 data/、reports/、output/ 文件夹)位于项目根目录内。
为了把个人数据和代码分开(更方便切换分支、拉取更新或测试多个个人资料),你可以按以下优先级配置一个外部数据目录:
- 环境变量: 设置
CAREER_OPS_ROOT或CAREER_OPS_DATA_DIR环境变量:export CAREER_OPS_ROOT=~/my-career-data - 标记文件: 在仓库根目录创建一个
.career-ops-data文件,内容是你的数据目录路径。 - 默认: 使用仓库根目录。
解析完成后,所有用户文件都相对于该文件夹解析和写入,而提示词文件和脚本仍然相对于仓库解析。
- 覆盖追踪文件: 你也可以设置
CAREER_OPS_TRACKER直接覆盖申请追踪文件的路径。 - 写入: 所有写入操作(如合并)都以
{DATA_ROOT}/data/applications.md为规范目标。 - 扫描器配置:
portals.yml在{DATA_ROOT}/portals.yml读取和校验,所以node validate-portals.mjs检查的正是scan.mjs读取的那个文件。 - 生成的文档: 定制简历和求职信写入
{DATA_ROOT}/output/,把它们关联到报告的 PDF 清单位于{DATA_ROOT}/data/pdf-index.tsv。在未设置CAREER_OPS_TRACKER时,限定这些写入范围的追踪工作区是数据根目录,而不是代码检出目录。 - 追踪文件覆盖下的 PDF:
generate-pdf.mjs会先解析CAREER_OPS_TRACKER,再推导工作区,所以设置了覆盖时,工作区就是存放该追踪文件的文件夹(如果追踪文件位于data/文件夹中,则是它的上一级文件夹)。这时简历的 HTML 和每个 PDF 都必须位于该工作区内,清单也会移到它的data/pdf-index.tsv。求职信仍以{DATA_ROOT}/output/为目标,所以当该文件夹不在追踪文件的工作区内时,求职信会被拒绝写入。 - 代码层保持不动:
node_modules/、providers/、modes/以及脚本本身始终相对于仓库解析,从不相对于数据根目录。
Go 版仪表板 TUI、Node.js 脚本和 AI 代理模式都会自动遵循这一解析层级。
技术栈
- 代理:带共享 skill 和模式的 AI 编码 CLI(
AGENTS.md+ 各 CLI 的包装) - PDF:Playwright + HTML 模板
- 求职信:HTML 模板 + Playwright(A4 PDF,与简历相同的流水线)
- 扫描器:Playwright + Greenhouse API + WebSearch
- 仪表板:Go + Bubble Tea + Lipgloss(Catppuccin Mocha 主题)
- 数据:Markdown 表格 + YAML 配置 + TSV 批处理文件
也可以在任何遵循 agent skill 标准的 CLI 中运行。见支持的 CLI。
也已开源
- cv-santiago:作品集网站(santifer.io),带 AI 聊天机器人、LLMOps 仪表板和案例研究。如果你需要一个配合求职展示的作品集,fork 它,改成你自己的。
常见问题(FAQ)
career-ops 是什么? career-ops(career-ops.org,也称 careerops) 是一个开源的 AI 求职工具,在你的 AI 编码 CLI(Claude Code、Codex、OpenCode 等)里本地运行,把每一个决定都留给你。它根据你的简历评估职位,生成适配 ATS 的 PDF,找到合适的联系人,并在一个地方追踪所有进展:最终决定始终在你手中。它是 CareerOps 宣言的首个参考实现。
定制简历会编造内容吗?
不应该,提示词里也这么写:只改写,绝不编造。generate-pdf 会拦下数字或事实在你的资料来源中找不到的简历,除非你传入 --skip-fact-check。pdf 模式还会运行 cv-title-check.mjs:它按公司和日期,把定制简历中的每个职位名称与 cv.md 中同一份工作的职位名称对比,有不同就请你决定保留还是改回。它只提醒、不拦截,因为调整职位名称的写法有时是你自己的选择。目前还没有任何检查评判改写:#1411(不通过即阻止的真实性检查)在跟进这一点。在此之前,每份简历发出前都请自己读一遍。法律声明 用更长的篇幅说了同样的话。
我可以免费运行 career-ops,或使用更便宜的本地模型吗? 可以。career-ops 不受特定 CLI 限制,可以用免费和本地模型运行(OpenRouter 免费模型、Ollama 或任何兼容 OpenAI 的端点),因此你不必绑定付费订阅。完整设置见 docs/RUNNING_ON_A_BUDGET.md。
我付了 Claude Pro/Max,但 career-ops 在消耗 API 额度。为什么?
因为环境里的 ANTHROPIC_API_KEY 优先于你已登录的订阅:CLI 会使用这个密钥并按 token 计费。运行 echo $ANTHROPIC_API_KEY,如果有输出,就把它从 shell 配置里删掉,重启终端并运行 /login。批量模式是例外,因为 claude -p worker 不使用交互式登录:运行一次 claude setup-token,把结果导出为 CLAUDE_CODE_OAUTH_TOKEN。完整步骤见 docs/RUNNING_ON_A_BUDGET.md。
career-ops 支持哪些 AI CLI? career-ops 通过开放的 Agent Skill Standard 运行在任何主流 AI 编码 CLI 上(Claude Code、Codex、Gemini / Antigravity、OpenCode、Grok、Qwen 等),所以永远不会被单一厂商锁定。用你已经有的 CLI 就行。
如何在 Windows 上安装 career-ops? career-ops 可以在 Windows 上运行。平台相关的设置和已知的坑(Git Bash 检测、行尾符、任务计划程序)在 docs/WINDOWS.md。如果安装时因符号链接错误导致 skills 无法加载,解决方法在 docs/FAQ.md。完整步骤见 docs/SETUP.md。
career-ops 会替我自动申请职位吗? 不会。career-ops 是一个过滤器,不是海投的自动申请器。AI 负责评估、排序和起草;你负责审阅与决定。它起草、填写,但从不提交。由你点击提交。这种保留人工决策的设计正是重点所在。
career-ops 是免费开源软件吗? 是。career-ops 是免费开源软件,而且对求职者会一直如此。它是 CareerOps 宣言的首个参考实现。读一读,如果它说出了你的想法,就签名。
关于作者
我是 Santiago Fernández de Valderrama Aparicio(santifer),曾经是创业者:我创办并卖掉了一家至今仍以我的名字运营的公司。我打造 career-ops 是为了管理自己的求职,它奏效了:它帮我拿到了一个 Head of Applied AI 的职位。六个月后,我离开了那个职位,全职投入 career-ops 的开发。
想知道这么大的仓库,是怎样由一支 AI 代理团队维护、每次合并都由人来决定的?读一读 Agentic maintenance: how career-ops is run by a fleet of AI agents。
我的作品集和其他开源项目 → santifer.io
Wikidata:Santiago Fernández de Valderrama Aparicio · career-ops。
免责声明
career-ops 是一个本地运行的开源工具,不是托管服务。 使用本软件即表示你确认:
- 你掌控自己的数据。 你的简历、联系方式和个人数据留在你的机器上,直接发送给你选择的 AI 提供商(Anthropic、OpenAI 等)。我们不收集、不存储、也无法访问你的任何数据。
- 你掌控 AI。 默认提示词指示 AI 不要自动提交申请,但 AI 模型可能出现不可预测的行为。如果你修改了提示词或使用其他模型,风险自负。提交前务必检查 AI 生成内容的准确性。
- 你遵守第三方条款。 你必须按照所交互招聘平台(Greenhouse、Lever、Workday、LinkedIn 等)的服务条款使用本工具。不要用本工具向雇主发送垃圾信息或冲击 ATS 系统。
- 不作任何保证。 评估是建议,不是事实。AI 模型可能虚构技能或经历。作者不对就业结果、被拒的申请、账号限制或任何其他后果负责。
完整内容见 LEGAL_DISCLAIMER.md。本软件依据 MIT 许可证"按原样"提供,不附带任何形式的保证。
贡献者
每一位贡献过代码、文档、翻译或测试的人都列在 CONTRIBUTORS.md 里,包括上面的图表无法展示的 非代码贡献。
用 career-ops 找到工作了?分享你的故事!
许可证与商标
代码以 MIT 许可证发布。"career-ops" 的名称和 品牌受商标政策约束:对社区使用宽松, 对商业产品命名和背书保留权利。
Star 历史
由 Santiago Fernández de Valderrama Aparicio(@santifer)创建并维护
联系我们